做ecel表时最耗时间的从来不是算总数,而是对着一堆乱粘的文本反复擦改:导出来的客户电话前后夹着看不见的空格、身份证号里手动抠生日、跨表格拼完的名单满屏都是连接符——明明你熬了半小时改的内容,几个文本函数就能30秒搞定,根本不是高手专属的复杂技能,哪怕是刚入门的新手,跟着场景套公式也能快速上手。
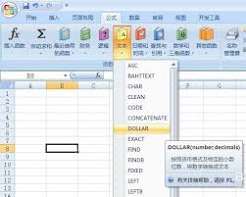
基础高频函数:30秒搞定文本清洗刚需
日常遇到最多的“脏数据”问题,靠三个入门函数就能解决。第一个是trim,专门清除文本前后、字符间多余的半角空格,不管是从业务系统导出、还是从其他文档粘贴的带空格数据,只要在空白单元格输入=trim(a2),下拉填充就能把所有夹空格的内容整成规范格式,再也不会出现vlookup匹配不到值的低级报错。第二个是clean,能删掉肉眼看不见的换行符、非打印控制字符,比手动逐行找换行高效得多,是清洗数据的隐形神器。还有最常用的截取类函数mid/left/right,要从18位身份证里抽取生日,直接输=mid(a2,7,8),就能精准定位从第7位开始的8位生日数字,不用逐个数字符位置。
进阶场景函数:把零散文本拧成可用信息
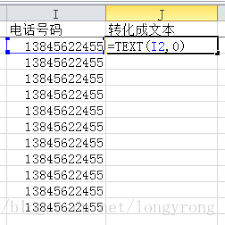
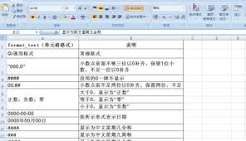
碰到需要整合信息的场景,几个进阶函数能省掉大半手动操作。tetjoin可以一次性把多个单元格的内容按指定分隔符拼接,比如要把同部门的员工名字用顿号连起来,输=tetjoin("、",true,a2:a10),一秒生成规整名单,不用挨个敲连接符凑公式。搭配find函数还能灵活截取不规则文本,比如要把“订单号:j20240512”里的冗余前缀去掉,用find定位冒号的位置,配合left函数就能一键抽取出纯订单编号,避免手动删改时漏字符。最后用tet函数可把数字批量转成指定格式,把零散日期统一成“2020月日”的展示样式,不用逐个调格式。
很多人对文本函数的印象是“记不住参数”,其实完全不用硬背,碰到对应的场景直接搜对应函数用法套进去,把重复的机械劳动交给公式,省下来的时间不管是早下班还是多核对一遍数据准错漏,都比对着表手动擦改划算得多。